
Tecnología
¿Por qué Meta se rinde y vuelve a depender de NVIDIA?

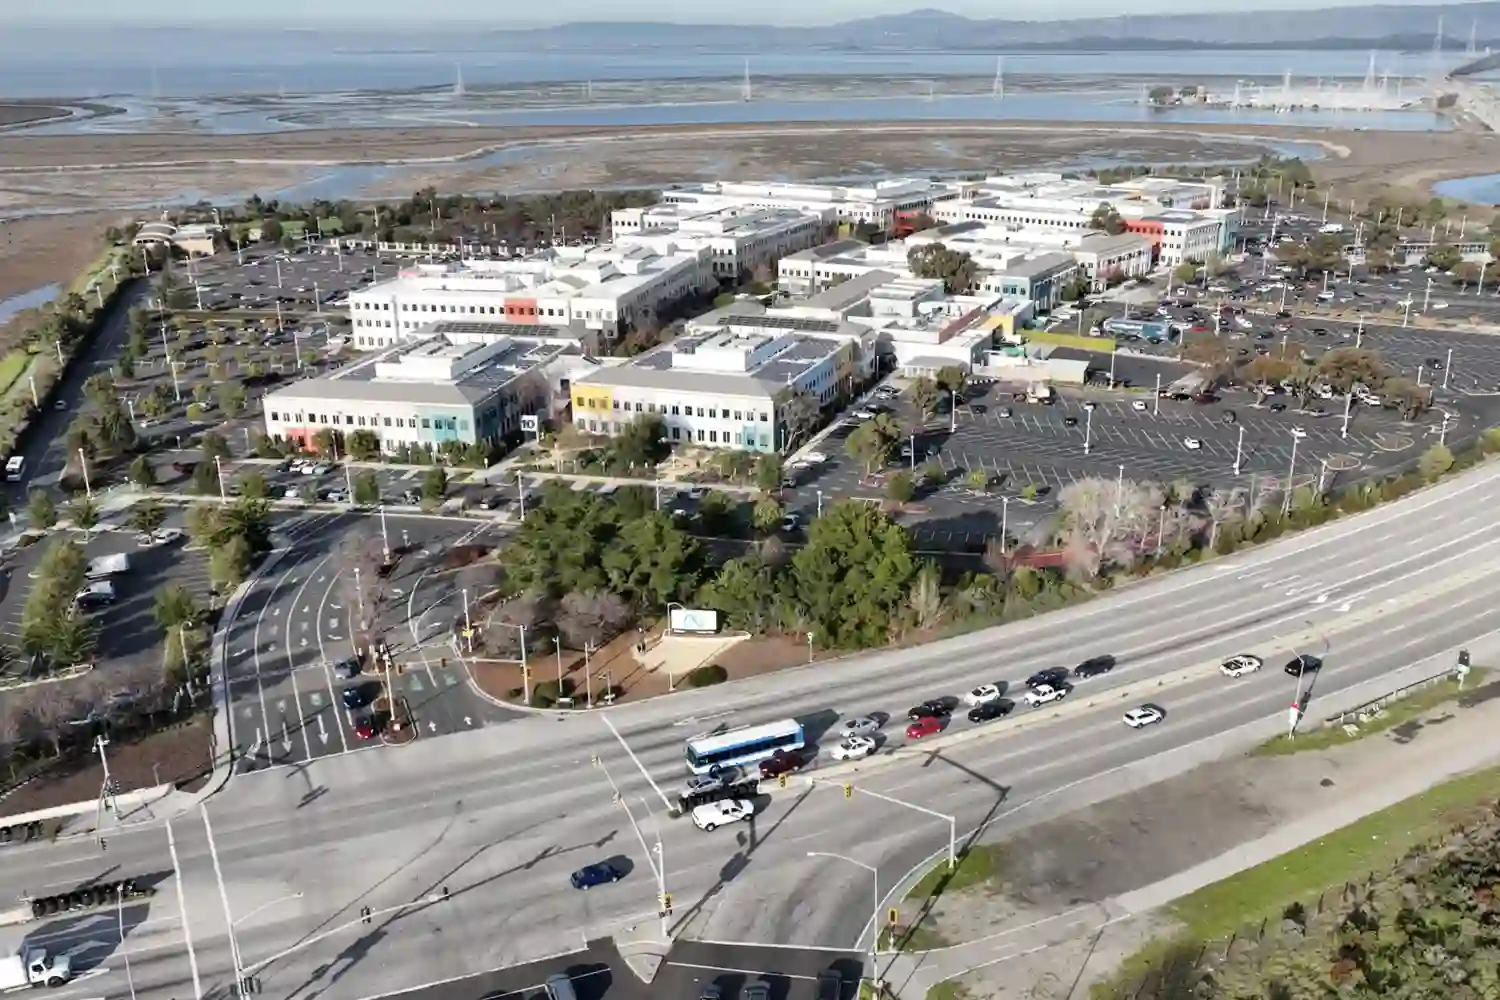
Meta frena Olympus, refuerza compras a NVIDIA, AMD y Google y deja al descubierto por qué fabricar chips de IA propios era mucho más difícil.
Meta quería hacer una jugada de poder. Diseñar sus propios chips de inteligencia artificial para entrenar modelos gigantes, recortar la factura de hardware y dejar de vivir pendiente de NVIDIA, la compañía de Jensen Huang que se ha convertido en el gran casero de la fiebre de la IA. El problema es que esa emancipación, tan limpia en la presentación y tan rentable en la teoría, se ha estrellado contra la parte menos vistosa del negocio: fabricar silicio puntero es una de las tareas más difíciles, caras y lentas de toda la industria tecnológica. Lo que ha trascendido en las últimas semanas es claro: Meta ha frenado Olympus, su chip interno más ambicioso para entrenamiento, y ha reforzado al mismo tiempo su compra masiva de capacidad externa.
La noticia no significa que Mark Zuckerberg haya tirado la toalla con la IA. Más bien al contrario. Meta está gastando más que nunca, levantando infraestructura a un ritmo colosal y firmando acuerdos millonarios para no quedarse atrás. Lo que sí revela este giro es algo bastante más incómodo: Meta puede construir productos, modelos y centros de datos a escala planetaria, pero todavía no ha conseguido resolver por sí sola el corazón físico del entrenamiento de la IA avanzada. Mientras tanto, seguirá tirando de NVIDIA, de AMD, de los TPU de Google y de sus propios chips allí donde sí le funcionan, sobre todo en inferencia, anuncios y recomendación de contenidos.
El proyecto que debía romper la dependencia
Durante años, Meta vio cómo el centro de gravedad tecnológico se desplazaba. Mientras OpenAI, Google y Microsoft tomaban posiciones en la carrera de la inteligencia artificial generativa, la compañía de Zuckerberg seguía arrastrando la resaca de su apuesta por el metaverso, una idea carísima, absorbente y todavía lejos de justificar todo el dinero enterrado en Reality Labs. Cuando Meta reaccionó, lo hizo con el estilo de siempre: a lo grande. Reorganizó equipos, fichó talento de primer nivel, aceleró su familia de modelos Llama, empujó Meta AI y, sobre todo, entendió que sin músculo de cálculo no había remontada posible.
Ahí aparecía la gran promesa del silicio propio. La lógica era impecable. Si Meta conseguía desarrollar un chip competitivo para entrenamiento, no solo abarataría costes en el medio plazo, también ganaría algo muchísimo más valioso: control sobre el calendario, sobre la capacidad instalada y sobre el destino de su propia hoja de ruta. En el mercado actual, depender de NVIDIA no es solo depender de una pieza. Es depender de la disponibilidad, del precio, del ecosistema de software, de la memoria, de la interconexión, de la prioridad de entrega y, en última instancia, del proveedor que hoy domina la infraestructura de la IA como antes Intel dominó el PC. Quien vende las palas en esta fiebre del oro manda más de lo que parece.
Meta llevaba tiempo trabajando en esa dirección con MTIA, siglas de Meta Training and Inference Accelerator, una familia de chips propios que la compañía ha presentado como parte central de su estrategia técnica. En 2025 empezó a probar su primer chip interno pensado para entrenar sistemas de IA, fabricado con apoyo de TSMC, y el movimiento sonó a punto de inflexión. Ya no era solo una promesa. Ya había prototipos, despliegues de prueba y una narrativa muy precisa: caminar, gatear, correr. Primero optimizar tareas concretas, luego escalar. Pero entre el laboratorio y la producción a gran escala hay un abismo. Y en ese abismo es donde se ha quedado Olympus, el diseño avanzado con el que Meta aspiraba a competir de verdad en el tramo más duro del hardware.
El entrenamiento era la parte más difícil
Conviene detenerse aquí, porque no todos los chips de IA hacen lo mismo, aunque en muchos titulares parezca que sí. Una cosa es la inferencia, que consiste en ejecutar un modelo ya entrenado para responder, recomendar, ordenar o clasificar. Otra muy distinta es el entrenamiento, que obliga a mover volúmenes descomunales de datos, coordinar miles de aceleradores a la vez, sostener flujos de memoria brutales y evitar que un fallo minúsculo desbarate semanas enteras de trabajo. Dicho de otro modo: usar la IA no es igual que construirla.
Meta sí ha conseguido avances reales en la parte menos glamurosa y más rentable del asunto. La propia empresa ha explicado que MTIA ya está desplegado a escala en sus centros de datos, sobre todo en cargas relacionadas con anuncios, ranking y recomendación, y que ahí ha obtenido ventajas de eficiencia frente al hardware de terceros. Ese detalle es importante porque desmonta una lectura simplona del caso. Meta no ha fracasado con todo su programa de chips. Ha tropezado justo en el lugar donde más presumía el sector y donde menos margen de error existe: en el entrenamiento de modelos grandes, la parte que define el liderazgo tecnológico y también la factura más feroz.
La IA moderna exige una especie de coreografía brutal entre compute, memoria, red, refrigeración, empaquetado avanzado y software. No basta con diseñar un chip rápido sobre el papel. Tiene que comportarse bien en cargas reales, escalar entre nodos, dialogar con el resto de la infraestructura y no convertirse en un quebradero de cabeza para los ingenieros cada vez que cambia el modelo. Ahí es donde NVIDIA lleva años de ventaja. No solo por el silicio. También por CUDA, por sus bibliotecas, por su experiencia con centros de datos, por la integración entre producto y software y por la inercia de un ecosistema que miles de desarrolladores y empresas ya conocen. Desalojar a NVIDIA no es comprar un billete de entrada; es reconstruir un barrio entero.
Un error cuesta meses y decenas de millones
El problema del silicio avanzado es que castiga como pocos sectores. En software, un error se corrige con un parche. En chips, un error puede costar meses, obligar a rehacer el diseño y consumir decenas de millones de dólares antes de saber siquiera si la siguiente iteración funcionará. Cada fase de fabricación, cada prueba, cada ajuste en memoria o interconexión tiene un precio descomunal. Y, además, el reloj corre. Mientras Meta corrige un cuello de botella o una incompatibilidad, NVIDIA sigue vendiendo Blackwell, preparando Rubin y consolidando su posición en los centros de datos de medio planeta. Por eso la caída de Olympus no es un tropiezo menor ni una anécdota de laboratorio. Es la prueba de que Meta todavía no ha encontrado la fórmula para convertir su ambición en un producto de entrenamiento robusto, competitivo y desplegable a gran escala.
NVIDIA gana, pero Meta ya compra en tres ventanillas
La respuesta de Meta a ese atasco ha sido muy poco romántica y muy reveladora: comprar más fuera. En febrero de 2026 se conoció un acuerdo multianual con NVIDIA para adquirir millones de chips actuales y futuros, incluidos sistemas basados en Blackwell y en la próxima generación Rubin, además de procesadores Grace y Vera. Es una operación enorme, aunque no se haya detallado oficialmente toda su cuantía, y deja una imagen bastante nítida. Meta quería reducir su dependencia de NVIDIA y ha acabado reforzándola en el peor momento para sus aspiraciones de autonomía.
Pero la foto no termina ahí. Casi al mismo tiempo, Meta anunció una alianza de largo plazo con AMD, la compañía de Lisa Su, para alimentar su infraestructura con hasta 6 gigavatios de GPUs Instinct a lo largo de varias generaciones. No es un acuerdo pequeño ni simbólico. Es un compromiso mastodóntico, pensado para alinear hojas de ruta de hardware, sistemas y software, con los primeros envíos previstos a partir de la segunda mitad de 2026 sobre una arquitectura basada en GPUs personalizadas derivadas de MI450, procesadores EPYC Venice y la plataforma Helios desarrollada junto a Meta. Dicho sin maquillaje: Meta no está eligiendo un sustituto único para NVIDIA; está llenando el almacén con todo lo que pueda darle capacidad de cómputo fiable.
A esa ecuación se ha sumado Google. También en febrero trascendió un acuerdo multianual y multimillonario para alquilar TPU, los Tensor Processing Units de Alphabet, con el objetivo de desarrollar nuevos modelos de IA. Los TPU son la gran alternativa interna que Google lleva años afinando para su propia nube y sus propios sistemas. Que Meta, uno de sus rivales más directos, recurra también a ellos dice mucho de la escasez relativa de capacidad, de la urgencia de entrenamiento y del pragmatismo que se ha impuesto en Menlo Park. Cuando el silicio propio no llega, la ideología se acaba rápido.
Diversificar no es independizarse
Aquí está la clave industrial del caso. Meta está diversificando, no independizándose. Son dos cosas muy distintas. Diversificar significa repartir riesgos, no quedarse atada a un solo proveedor, ganar margen de negociación, adaptar distintas cargas de trabajo a distintos chips y evitar cuellos de botella en una demanda que no deja de crecer. Independizarse, en cambio, sería poder entrenar sus sistemas más estratégicos con hardware diseñado y controlado íntegramente por la propia Meta. Eso, a día de hoy, no ha sucedido.
La propia Meta lleva meses describiendo su infraestructura con una “portfolio-based approach”, una estrategia de cartera en la que conviven NVIDIA, AMD, silicio propio y, ahora, también Google. La idea suena sofisticada y lo es, pero también es el reconocimiento de una limitación muy concreta. Meta no dispone todavía de una pieza doméstica capaz de asumir por sí sola el núcleo de su carrera por la IA. Lo que tiene es una combinación de recursos que le permite seguir avanzando mientras gana tiempo. Y el tiempo, en esta industria, vale miles de millones.
El dinero dejó el metaverso y se fue al centro de datos
Todo esto ocurre, además, en un momento financiero decisivo. Meta cerró 2025 con ingresos de 200.966 millones de dólares, una cifra gigantesca que explica por qué puede permitirse semejante nivel de gasto sin que el mercado la castigue con demasiada dureza. La publicidad sigue financiando la fiesta. Los anuncios en Facebook, Instagram, WhatsApp y Threads sostienen el resto del edificio. Gracias a ese motor, la compañía desembolsó 72.220 millones de dólares en capex en 2025 y ha proyectado para 2026 una inversión de entre 115.000 y 135.000 millones, con unos gastos totales previstos de entre 162.000 y 169.000 millones. Son números descomunales incluso para una gran tecnológica. Ya no es una aceleración. Es una mudanza completa del centro de la empresa hacia la IA.
El contraste con la etapa del metaverso es brutal. Durante años, el agujero de Reality Labs simbolizó una apuesta futurista que devoraba recursos mientras el negocio principal seguía pagando la cuenta. Ahora el dinero sigue saliendo a chorros, sí, pero el destino ha cambiado. Ya no va sobre todo a mundos virtuales con un retorno difuso, sino a centros de datos, fibra, memoria, racks, refrigeración, nubes externas y aceleradores especializados. Es un gasto mucho más material, más útil para el negocio inmediato y también más reconocible para los inversores. La gran obsesión de Zuckerberg ya no es fabricar presencia virtual. Es garantizar cálculo suficiente para que Meta AI, Llama y sus sistemas publicitarios no se queden atrás.
Hay otro detalle revelador. Susan Li, directora financiera de Meta, ha admitido que la empresa seguirá afrontando restricciones de capacidad durante buena parte de 2026. Es decir, ni siquiera con este nivel de inversión monstruosa tiene resuelto el suministro interno que necesita. Por eso Meta está recurriendo también a terceros para alquilar capacidad y acelerar despliegues. El mercado de la IA no se está jugando solo en los laboratorios y en los modelos. Se está jugando en la obra civil, en la energía disponible, en los permisos, en la refrigeración y en la velocidad con la que una compañía puede conectar miles de aceleradores sin que aquello reviente por temperatura o por red.
La propia Meta ha enseñado ya parte de esa magnitud. Ha hablado de Prometheus, un clúster de 1 gigavatio distribuido entre varios edificios, y de Hyperion, un proyecto todavía mayor con capacidad prevista de hasta 5 gigavatios cuando esté completo. También ha mostrado configuraciones con 72 GPUs Blackwell en solo dos racks centrales, con consumos de alrededor de 140 kilovatios, un nivel de densidad que obliga a desplegar refrigeración líquida asistida por aire para que el hardware no se convierta literalmente en una tostadora de lujo. Esto es lo que a menudo se pierde cuando se habla de IA como si fuera solo software. La inteligencia artificial moderna es también una industria eléctrica, térmica y logística.
El chip que Meta todavía no puede fabricar
Lo ocurrido con Olympus no liquida a Meta como aspirante en la carrera de la IA. Sería un diagnóstico facilón y falso. Meta sigue siendo uno de los actores con más dinero, más usuarios y más capacidad de ejecución del planeta. Tiene una familia de modelos con peso real en el mercado, una base publicitaria inmensa que financia su expansión, alianzas industriales agresivas y una voluntad clarísima de competir. Pero la noticia sí le arranca una capa de relato. Le quita la pose de independencia rápida y la devuelve a una verdad mucho menos épica: en la frontera del hardware, incluso Meta tiene que comprar tiempo.
También deja tocada una idea que había ganado fuerza en Silicon Valley: la de que cualquier gigante con caja suficiente puede diseñar su propio camino y sacudirse a los proveedores dominantes. No es tan sencillo. Google puede hacerlo porque lleva años empujando TPU dentro de su propia nube y de sus propios servicios. Amazon tiene su recorrido con Trainium e Inferentia. Microsoft empuja sus propios proyectos. Pero cada caso arrastra una historia técnica, una madurez interna y unas ventajas distintas. Meta, que sí ha demostrado fuerza en chips orientados a inferencia y recomendación, todavía no ha cruzado con éxito la frontera del entrenamiento avanzado. Y esa frontera es la que determina quién marca el paso en la próxima generación de modelos.
Hay, además, una ironía poderosa en todo esto. Meta quería dejar de depender de NVIDIA justo cuando más necesita potencia de cómputo, y el atasco de su chip interno la obliga a firmar acuerdos todavía más grandes con NVIDIA. También con AMD. También con Google. Lo que iba a ser una vía de escape se ha convertido, al menos por ahora, en una confirmación del dominio ajeno. No porque falten ingenieros o dinero en Menlo Park, sino porque la complejidad del silicio avanzado ya no admite atajos. No basta con diseñar una pieza brillante. Hay que integrarla, refrigerarla, producirla, escalarla y hacer que encaje con modelos que cambian de forma casi cada trimestre.
Eso es lo que realmente cuenta esta historia. Meta no se ha rendido ante la IA; se ha rendido, de momento, ante la idea de que podía controlar por sí sola el tramo más duro del hardware en el plazo que necesitaba. Seguirá empujando MTIA, seguirá construyendo centros de datos, seguirá comprando chips a varias bandas y seguirá vendiendo la promesa de una infraestructura propia cada vez más sólida. Pero el dato que importa es otro: cuando ha llegado el momento de asegurar entrenamiento real, Meta ha tenido que volver al mercado y aceptar que NVIDIA sigue ocupando el centro del tablero. No es una derrota definitiva. Es una corrección de realidad. Y en la guerra de la IA, a veces esa corrección cuesta muchísimo más que un chip fallido.


Para qué sirve realmente el cajón de abajo del horno (y por qué casi nadie lo usa bien)

De Lora del Río a Escocia: el ánfora de aceite que cuenta la primera globalización

El Mediterráneo se calienta y la posidonia florece como nunca: por qué es alerta y esperanza a la vez

La caja negra de los volcanes: los cristales que guardan el secreto de las erupciones

Un año después de la DANA: casi la mitad de los afectados sigue con malestar psicológico

¿Cuáles son los mejores casinos sin licencia en España en 2026?

¿Qué son los casinos fuera de España y qué licencia internacional tiene cada uno en 2026?

¿Qué son los casinos sin DNI y cuándo piden verificar tu identidad en 2026?

¿Qué son los casinos con licencia de Curazao y cómo elegir uno fiable en 2026?

¿Cuáles son los mejores casinos online europeos en 2026 y cómo elegir uno seguro desde España?

¿Qué son los casinos sin autoprohibición y es legal jugar en ellos desde España en 2026?
