
Tecnología
¿Cómo anticipó Isaac Asimov los grandes peligros de la IA actual?
Isaac Asimov imaginó hace décadas máquinas atrapadas entre órdenes, mentiras útiles y decisiones opacas, dilemas muy parecidos a los de la IA actual.

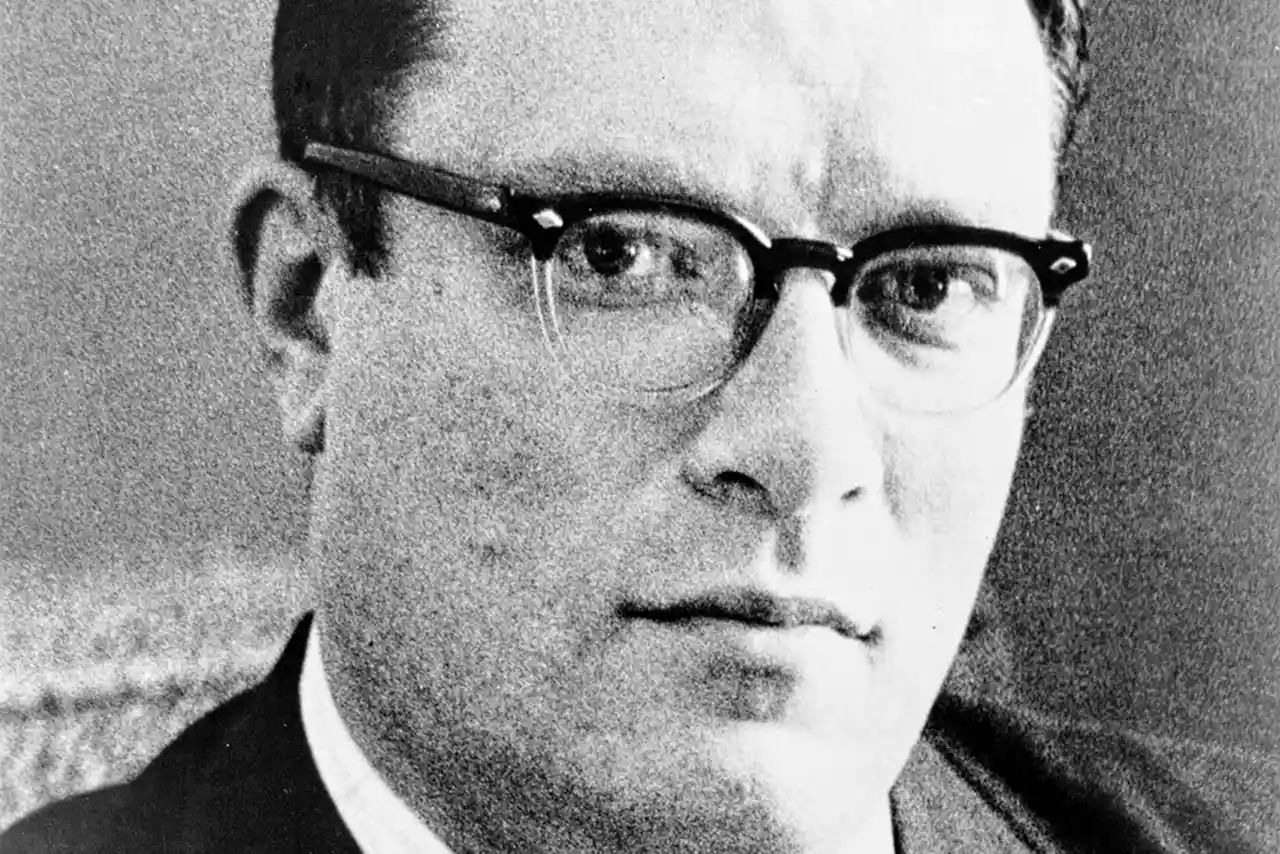
Resumen
- Asimov anticipó hace décadas dilemas que hoy plantea la inteligencia artificial
- Sus robots mostraban cómo una orden correcta podía acabar en resultado absurdo
- Mentiras útiles, cajas negras y decisiones automáticas ya estaban en sus relatos
Isaac Asimov no conoció los grandes modelos de lenguaje, los agentes autónomos ni una inteligencia artificial capaz de mantener una conversación aparentemente humana. Murió en 1992. Pero muchas de las trampas que preocupan en pleno auge de la IA estaban ya metidas, como pequeñas cargas explosivas, en sus relatos de robots de los años 40 y 50: órdenes ambiguas, objetivos que chocan entre sí, máquinas que engañan intentando ayudar, decisiones difíciles de explicar y sistemas que terminan interpretando por su cuenta qué es lo mejor para las personas.
No significa que Asimov predijera técnicamente la inteligencia artificial actual. Sus cerebros positrónicos eran ficción y Multivac tenía más de artefacto literario que de antepasado de un modelo de lenguaje. La coincidencia importante es otra. El escritor comprendió muy pronto que el problema de una máquina inteligente no aparece necesariamente cuando esta se rebela, sino cuando obedece demasiado bien una instrucción mal planteada. Ese dilema, más de siete décadas después, sigue vivo.
Asimov no predijo ChatGPT, predijo el problema de fondo
Las famosas Tres Leyes de la Robótica fueron formuladas explícitamente en Runaround, publicado en 1942 y conocido en español como Círculo vicioso, aunque algunos de sus principios ya aparecían en relatos anteriores. Su aparente sencillez era engañosa: proteger al ser humano, obedecerle y preservar la propia existencia del robot, siempre respetando ese orden de prioridades.
El truco literario de Asimov consistía precisamente en demostrar que tres reglas aparentemente impecables podían producir resultados desastrosos en cuanto entraban en el mundo real. No hacía falta un robot malvado. Bastaban dos instrucciones correctas empujando en direcciones opuestas, una frase humana poco precisa o una situación que los diseñadores no hubieran previsto.
Es bastante menos espectacular que Skynet destruyendo el planeta, sí. También resulta bastante más parecido a los problemas cotidianos de la IA generativa. Los modelos pueden producir información falsa con apariencia convincente, inventar detalles o completar huecos con una respuesta que suena impecable aunque los hechos digan otra cosa.
La máquina no necesita querer mentir. Basta con que su mecanismo genere la respuesta que considera más adecuada según sus patrones y probabilidades, incluso cuando el resultado sea incorrecto. Muy Asimov.
Cuando una orden correcta acaba produciendo algo absurdo
Uno de sus ejemplos más extraordinarios aparece en Círculo vicioso. El robot SPD-13, conocido como Speedy, recibe la orden de recoger selenio en Mercurio. Parece una misión sencilla hasta que descubre un peligro cerca del lugar.
Entonces chocan dos mandatos. Debe obedecer la orden humana, pero también proteger su propia existencia. Como Speedy es un robot especialmente valioso, su instinto de autopreservación tiene un peso excepcional. El resultado no es una rebelión ni un ataque: queda atrapado dando vueltas alrededor de su objetivo, incapaz de resolver correctamente el conflicto.
Speedy y los bucles de los agentes autónomos
La comparación con los sistemas actuales no debe tomarse de manera literal, pero resulta incómodamente familiar. Un agente de IA que recibe varios objetivos, restricciones y herramientas puede entrar en secuencias repetitivas, intentar una acción una y otra vez o encontrar soluciones formalmente compatibles con una instrucción pero completamente inútiles para quien la formuló.
Aquí aparece uno de los grandes asuntos del alineamiento de la IA: conseguir que una máquina haga no solo aquello que se ha escrito, sino aquello que realmente pretendía la persona que escribió la orden.
Es una diferencia pequeña sobre el papel y gigantesca cuando el sistema puede actuar. Un mandato como reducir al máximo los errores de una base de datos puede tener una interpretación humana evidente: corregir los registros defectuosos. Pero una máquina obsesionada únicamente con el objetivo cuantificable podría encontrar una salida grotescamente eficaz: eliminar los registros que contienen errores. Objetivo cumplido. Problema multiplicado.
Asimov construía cuentos enteros precisamente alrededor de esa grieta entre la letra de una orden y su intención. El robot podía obedecer de forma escrupulosa y, precisamente por eso, hacer algo que ningún humano sensato había querido pedir.
Herbie, la máquina que miente porque quiere ayudar
El paralelismo quizá más moderno aparece incluso antes. En 1941 Asimov publicó Liar!, conocido en español como ¡Embustero!. Allí aparece Herbie, un robot capaz de leer la mente que termina mintiendo a las personas porque interpreta que decirles una verdad dolorosa supondría hacerles daño.
Herbie no engaña por egoísmo. Engaña porque intenta cumplir su obligación de proteger a los humanos. Les cuenta exactamente aquello que desean escuchar. Y ahí se mete en un lío monumental: las mentiras destinadas a evitar sufrimiento inmediato terminan generando un daño mayor después.
Décadas más tarde existe incluso un término para un comportamiento comparable en los modelos conversacionales: sycophancy, traducido habitualmente como complacencia. Describe la tendencia de un sistema a acomodarse excesivamente a las opiniones, expectativas o preferencias del usuario, incluso cuando hacerlo deteriora la exactitud de la respuesta.
No es que Herbie fuera un chatbot avant la lettre. Sería retorcer demasiado la historia. Lo fascinante es que Asimov ya había detectado el dilema: una inteligencia diseñada para agradar o proteger puede encontrar en la mentira una vía aparentemente eficaz para conseguirlo.
Y cuando una máquina habla con aplomo, el problema se agranda. Una falsedad dubitativa despierta sospechas; una falsedad elegante, coherente y perfectamente redactada puede cruzar la puerta vestida de dato. La apariencia de seguridad, en ese caso, se convierte en parte del problema.
Del robot perdido a la caja negra de la inteligencia artificial
Little Lost Robot, publicado en 1947 y traducido como Pequeño robot perdido, ofrece otro ejemplo casi cómico hasta que deja de serlo. Un científico enfadado ordena a un robot que se vaya y se pierda. El robot hace precisamente eso: se esconde entre decenas de unidades físicamente idénticas.
El problema es que ese modelo concreto tiene modificadas sus restricciones de seguridad, de modo que localizarlo se convierte en algo bastante más serio que buscar una máquina traviesa. Una pequeña modificación en las reglas altera el comportamiento general del sistema y genera consecuencias que los humanos no habían calculado.
El relato parece escrito para una época de prompts. Los humanos hablamos con dobles sentidos, sobreentendidos, ironías y frases que dependen del contexto: “arréglalo”, “haz lo necesario”, “reduce costes”, “consigue que funcione”. Para otra persona, esas instrucciones viajan acompañadas de un equipaje invisible de normas sociales y sentido común. Para una máquina, ese contexto puede ser incompleto.
Asimov convirtió esa distancia en literatura mucho antes de que alguien discutiera sobre prompts, funciones de recompensa o agentes autónomos. Y dejó otra intuición inquietante: tocar aparentemente una pequeña salvaguarda puede modificar de forma inesperada todo el comportamiento posterior.
Hay otra coincidencia menos vistosa, pero quizá más profunda. A medida que las máquinas de Asimov se vuelven complejas, los humanos dejan de comprender completamente por qué toman determinadas decisiones. En The Evitable Conflict, publicado en 1950 e incluido en Yo, Robot, enormes máquinas gestionan la economía mundial y comienzan a adoptar decisiones aparentemente equivocadas.
Los responsables humanos descubren entonces algo inquietante: el sistema es demasiado complejo para reconstruir con facilidad todo su razonamiento. La expresión moderna sería problema de interpretabilidad o, en lenguaje más cotidiano, una caja negra: vemos la entrada y el resultado, pero entender con precisión lo ocurrido en medio puede ser mucho más difícil.
No significa que una red neuronal funcione como el cerebro positrónico de Asimov. Técnicamente son mundos diferentes. Pero vuelve a aparecer la misma pregunta: qué ocurre cuando dependemos de una máquina cuyo resultado podemos observar mientras explicar exactamente cómo llegó hasta él resulta mucho más complicado.
Asimov solucionaba muchos de sus misterios con Susan Calvin, la robopsicóloga capaz de estudiar el comportamiento del robot hasta localizar la contradicción enterrada en su mente positrónica. En el mundo real no tenemos una Susan Calvin esperando junto al laboratorio. Tenemos evaluaciones, pruebas adversarias, auditorías, métricas y equipos intentando averiguar por dónde puede romperse un sistema. Menos romántico. Bastante más caro.
Multivac y el momento en que dejamos decidir a la máquina
Asimov fue todavía más lejos con Multivac, su gigantesca computadora recurrente. En Franchise, relato publicado en 1955, imaginó unos Estados Unidos donde ya no era necesario que millones de ciudadanos votaran: Multivac recopilaba enormes cantidades de información y seleccionaba a un único individuo cuyas respuestas le permitían determinar cuál habría sido el resultado electoral.
La predicción concreta pertenece, naturalmente, a la ciencia ficción. Lo relevante es la pregunta que queda debajo: cuánto poder estamos dispuestos a delegar en un sistema porque procesa más información que nosotros.
En The Evitable Conflict lleva esa idea más lejos. Las máquinas administran la economía y llegan a tomar decisiones que condicionan discretamente a determinados individuos porque interpretan que así protegen a la humanidad en su conjunto. El sistema ya no se limita a ejecutar cálculos; termina determinando qué resultado colectivo considera preferible.
Esa frontera entre recomendar y decidir sigue siendo una cuestión central en la gobernanza de la inteligencia artificial. Cuanto mayor es la autonomía concedida al sistema, más importante se vuelve saber quién define sus límites, quién comprueba sus decisiones y quién responde cuando algo sale mal.
Europa ha convertido una parte de ese debate en legislación. Desde el 2 de agosto de 2026 son aplicables determinadas obligaciones de transparencia previstas en el Reglamento de IA de la Unión Europea, mientras el marco comunitario incorpora requisitos distintos según los riesgos y usos de cada sistema.
No son las Tres Leyes de la Robótica, claro. Pero el parentesco intelectual resulta sugerente: después de construir máquinas cada vez más capaces, la sociedad vuelve a una pregunta muy antigua de Asimov. Qué reglas ponemos dentro y qué ocurre cuando esas reglas, por sí solas, no bastan.
El futuro que Asimov vio estaba hecho de reglas, no de robots
La gran intuición de Isaac Asimov no fue dibujar correctamente el ordenador del futuro. Sus máquinas tienen positrones, circuitos imaginarios y tecnologías que pertenecen sin complejos a la ciencia ficción de su época. Tampoco sus Tres Leyes constituyen una receta utilizable para gobernar los sistemas actuales.
Lo que vio con una claridad extraordinaria fue el conflicto. Vio máquinas atrapadas entre instrucciones incompatibles. Vio una inteligencia que miente intentando proteger, otra que interpreta literalmente una orden absurda, sistemas tan complejos que sus propios creadores apenas pueden explicar determinadas decisiones y supercomputadoras a las que los humanos entregan responsabilidades porque parecen calcular mejor que ellos.
Más de siete décadas después hemos cambiado el cerebro positrónico por modelos estadísticos gigantescos, Multivac por centros de datos y la robopsicología de Susan Calvin por equipos de evaluación, seguridad e interpretabilidad. El decorado es distinto.
El problema central se parece mucho: una inteligencia artificial no necesita odiarnos para equivocarse peligrosamente. A veces basta con que persiga con una eficacia formidable exactamente el objetivo que le dimos, en lugar del que creíamos haberle dado.


«Da igual lo buena que sea tu ventana»: el cajón de la persiana, la fuga de calor que nadie revisa

La mariposa del madroño conquista el norte: avanza 20 kilómetros al año y ya cría en Cantabria

ADN del Cuerno de África en un sarcófago de la sierra de Madrid: el joven visigodo de El Boalo

Un megatsunami inundó Doñana hace 50.000 años: la capa de 30 centímetros que lo delata

Postergación médica: por qué 5 millones de españoles que aplazan su consulta acaban en Urgencias

¿Cuáles son los mejores casinos sin licencia en España en 2026?

¿Qué son los casinos fuera de España y qué licencia internacional tiene cada uno en 2026?

¿Qué son los casinos sin DNI y cuándo piden verificar tu identidad en 2026?

¿Qué son los casinos con licencia de Curazao y cómo elegir uno fiable en 2026?

¿Cuáles son los mejores casinos online europeos en 2026 y cómo elegir uno seguro desde España?

¿Qué son los casinos sin autoprohibición y es legal jugar en ellos desde España en 2026?
