Tecnología
¿Cómo aprende un robot a mover los labios como tú?
Un robot de Columbia aprende a mover los labios y cantar como un humano tras verse al espejo y analizar vídeos de YouTube con IA y motores faciales precisos En Columbia Engineering, en Nueva York.

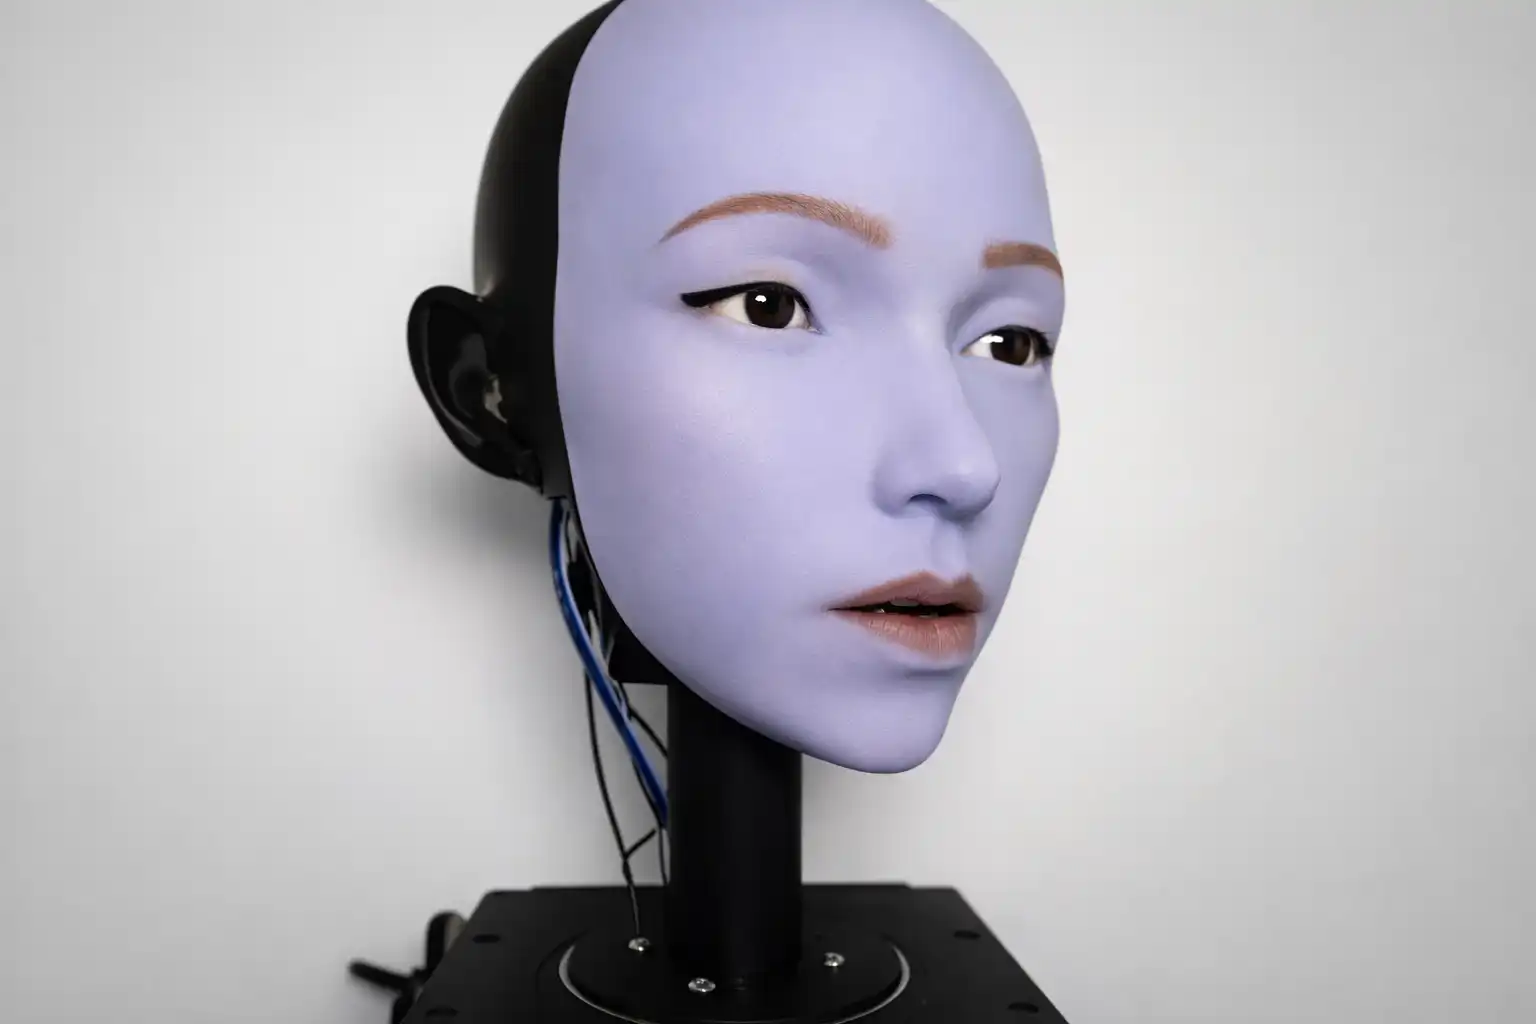
Foto: YouTube
Un robot de Columbia aprende a mover los labios y cantar como un humano tras verse al espejo y analizar vídeos de YouTube con IA y motores faciales precisos
En Columbia Engineering, en Nueva York, un grupo del Creative Machines Lab ha puesto a un robot a hacer algo tan cotidiano que casi pasa desapercibido… hasta que no sale bien: mover los labios al ritmo de una voz. El robot se llama EMO y no es un cuerpo completo caminando por un pasillo, sino un rostro robótico de gran realismo, recubierto de piel de silicona y gobernado por 26 motores faciales capaces de mover de forma independiente labios, mandíbula y mejillas. El avance, presentado por el equipo como un salto en robótica humanoide, es que EMO aprendió la sincronía labial de manera observacional: primero “entendiendo” su propia cara frente a un espejo y después viendo durante horas vídeos de YouTube de personas hablando y cantando, hasta construir una relación funcional entre audio y movimiento.
La clave está en el método, no en el truco. No hay aquí un guion rígido de gestos preprogramados para cada fonema, ni una biblioteca de bocas diseñada a mano. El trabajo, firmado por investigadores de Columbia con Hod Lipson al frente —profesor James and Sally Scapa de Innovación en el Departamento de Ingeniería Mecánica y director del laboratorio— y con el doctorando Yuhang Hu como figura central en el desarrollo, se publicó en Science Robotics y se anunció a mediados de enero de 2026 como una demostración de que un androide puede aprender un comportamiento humano nuevo observando, con una naturalidad visual que hasta ahora se le atragantaba a casi cualquier cara robótica.
La cara que parecía el problema y terminó siendo el campo de pruebas
Durante años, buena parte de la robótica humanoide ha vivido obsesionada con piernas y manos: caminar sin caerse, agarrar sin romper, levantarse sin parecer un mueble con prisa. Todo eso sigue siendo difícil, pero la cara —la cara es otra cosa— porque no se evalúa solo con física, sino con percepción. Una boca que llega tarde, que se abre de más, que pronuncia “a” como si fuera “o”, dispara ese malestar que tantos describen como valle inquietante: parece humano… pero no cuadra. Con EMO, Columbia ha puesto el foco justo ahí, en el lugar donde el cerebro no perdona.
El robot es, ante todo, una plataforma facial. La silicona no está por estética, está por mecánica: permite microdeformaciones y continuidad en el gesto. Los 26 motores no están por espectáculo, están para dar grados de libertad, para que la boca no sea una bisagra sino un sistema con matices. El equipo insiste en que lograr un movimiento labial convincente es doblemente difícil: hace falta hardware capaz de moverse rápido y con silencio, y hace falta resolver el rompecabezas de cómo el habla —una secuencia de sonidos— se convierte en un baile milimétrico de labios y mandíbula. Si uno de esos dos pilares falla, la ilusión se cae. Aquí, la apuesta fue reforzar ambos.
En las demostraciones asociadas al trabajo, EMO articula palabras en varios idiomas y se permite incluso cantar, una prueba que complica las cosas porque el canto estira vocales, cambia el ritmo y obliga a sostener formas bucales que en el habla normal duran un instante. Como guiño, el robot interpreta una pieza vinculada a un debut musical de sello peculiar: un álbum generado por IA titulado “hello world_”. No es el centro del avance, pero sí es un escaparate perfecto: si resiste el canto sin volverse caricatura, hablar se vuelve menos cuesta arriba.
El entrenamiento empieza con un espejo y miles de gestos raros
El proceso de aprendizaje se desarrolló por etapas, y la primera tiene algo de escena íntima. Colocaron a EMO frente a un espejo y lo dejaron explorar su propio rostro, moviendo motores al azar, repitiendo gestos, probando combinaciones como un niño que descubre que puede fruncir el labio superior o tensar la comisura. Ese tramo no es anecdótico: sirve para construir una especie de mapa interno que conecte órdenes motoras con formas faciales observables. En términos simples y sin solemnidad innecesaria, el robot aprende qué pasa cuando “tira” de un motor u otro: qué aspecto adopta la boca, cómo cae la mandíbula, cómo cambia la curvatura del labio.
Ese aprendizaje inicial es crucial porque evita depender de un modelo geométrico perfecto de la cara, algo que en la práctica suele ser frágil y lleno de aproximaciones. Al aprender desde la observación de sí mismo, EMO se fabrica su propio diccionario de movimientos: “si activo esto así, mi boca se ve así”. Es la base que luego permitirá algo mucho más ambicioso: traducir sonido en gesto sin que todo se derrumbe cuando cambie la voz o el idioma.
Hay, además, una ventaja silenciosa en empezar por uno mismo: el robot no aprende “cómo debería moverse una cara ideal”, aprende cómo se mueve su cara real, con sus tensiones, su elasticidad concreta, su pequeña imperfección física. En robótica, ese detalle suele marcar la diferencia entre una demo bonita y una capacidad reutilizable.
YouTube como maestro: del audio al gesto sin reglas rígidas
La segunda fase es la que ha hecho que el proyecto dé la vuelta al mundo: EMO pasó horas viendo vídeos de YouTube de personas hablando y cantando. Mientras la cara robótica observa esos labios humanos, un modelo de IA analiza la relación entre lo que se oye y lo que se ve: el patrón del audio, la forma que adopta la boca, el ritmo de apertura y cierre, la anticipación de una consonante, el redondeo de una vocal sostenida. No es que EMO “entienda” el contenido del vídeo; lo que aprende es una correspondencia estadística y dinámica entre sonidos y movimientos faciales.
Aquí entra una diferencia que separa este trabajo de muchos sistemas anteriores. En robótica facial se ha tirado durante años de reglas: “para esta vocal, esta forma”, “para esta consonante, este gesto”, como si el habla fuera una tabla fija. Pero el habla real se parece más a un río que a una tabla: coarticulación, velocidad, acentos, variaciones individuales, pequeñas trampas del idioma. Un método basado en observación puede capturar esa fluidez con mayor naturalidad, sobre todo cuando se combina con el mapa previo que EMO ya construyó frente al espejo.
Columbia describe que, con ambos modelos en la mano —el que entiende su propia cara y el que relaciona audio y labios humanos—, el sistema puede traducir audio directamente a acción motora en tiempo real. Dicho sin florituras: suena una voz y la boca se organiza para seguirla, con un grado de precisión suficiente como para que deje de parecer un muñeco mal doblado.
Lo que hay bajo la silicona: 26 motores y una coreografía de milisegundos
La cifra de 26 motores faciales no es un adorno técnico para impresionar, es el núcleo del realismo. Cada motor puede empujar o tirar en puntos concretos, y la suma de todos permite una diversidad de formas bucales mucho más cercana a la humana que la típica cara rígida con dos o tres servos. Labios, mandíbula y mejillas trabajan en conjunto. Y no basta con que “puedan” moverse; deben hacerlo rápido y en silencio, porque una cara que vibra o suena mecánica arruina la sensación de continuidad.
El equipo explica que parte del problema de la sincronía labial es el tiempo: un gesto debe llegar cuando toca, ni antes ni después. La boca se prepara para el sonido que viene, arrastra la forma anterior, corrige sobre la marcha. Una consonante explosiva exige un cierre preciso; una vocal abierta pide espacio; un sonido nasal cambia tensiones; una nota larga en canto exige estabilidad sin rigidez. Todo eso se decide en fracciones de segundo. La robótica lo llama control; el cuerpo humano lo hace sin pensarlo.
En el trabajo se menciona que EMO es capaz de cubrir un conjunto amplio de formas relacionadas con consonantes y vocales, y que esa riqueza reduce fallos típicos: movimientos faciales robóticos que no corresponden con la voz, labios que se abren sin sentido, gestos demasiado grandes o demasiado planos. Aquí, el movimiento intenta ser detallado, más fino, menos teatral. Y aun así, el equipo admite puntos débiles. En sus propias declaraciones reconocen dificultades con sonidos duros como la “B” y con fonemas que exigen fruncimiento marcado, como la “W”. Son los tropiezos que, curiosamente, hacen el relato más creíble: si alguien dijera “funciona perfecto”, sonaría a presentación de feria.
Esa honestidad también apunta a una idea práctica: el sistema puede mejorar con más interacción, más práctica, más datos. Lipson lo resume con una frase que encaja bien con el enfoque observacional: cuanto más trate con humanos, mejor lo hará. No es magia; es aprendizaje acumulado.
Qué demuestra este experimento y qué no conviene vender como milagro
Lo que demuestra con claridad es que un robot puede aprender un comportamiento facial complejo —sincronizar labios— sin que un equipo de ingenieros le escriba a mano cada regla de movimiento. Ese cambio de paradigma importa porque escala: si hoy es la boca, mañana podrían ser microexpresiones, gestos de escucha, señales sociales que hacen que una interacción deje de ser “robótica” en el mal sentido.
También muestra algo menos obvio: el entrenamiento por observación puede ser multilingüe o, al menos, no quedar atrapado en un idioma concreto. En la presentación pública se insiste en que EMO articula en distintos idiomas y se le ha atribuido capacidad para sincronizar en inglés y otros como francés, chino o árabe. Lo prudente es quedarse con el hecho verificable de su generalización: el sistema aprende patrones entre sonido y movimiento que no dependen estrictamente del significado del lenguaje, y eso abre la puerta a que funcione en contextos lingüísticos variados si los datos y la señal de audio lo sostienen.
Ahora bien, lo que no hace EMO, y conviene decirlo sin dramatismo, es “hablar como un humano” en el sentido mental. EMO no piensa, no decide qué decir con intención propia, no entiende el contenido semántico como lo hace una persona. Su avance está en la forma: la sincronía visual del habla. Y eso, en robótica social, puede ser enorme sin necesidad de atribuirle conciencia o personalidad. Es una interfaz, un puente, una pieza.
Tampoco estamos ante un producto listo para desplegarse en un entorno sensible mañana por la mañana. La robótica facial realista tiene retos de mantenimiento, durabilidad de materiales, fiabilidad de motores, calibración, coste. La piel de silicona envejece; los actuadores sufren; el realismo exige tolerancias pequeñas. En laboratorio funciona; convertirlo en algo robusto es otro partido.
Dónde encaja EMO: robots sociales, telepresencia y la industria de la “cara creíble”
La utilidad inmediata de una sincronía labial convincente aparece en cualquier entorno donde la comunicación cara a cara importa, aunque sea a través de una máquina. Telepresencia con un rostro físico que acompaña a una voz remota, asistentes en espacios públicos que necesiten dar información sin parecer un altavoz con máscara, robots en museos o centros de divulgación donde el gesto ayuda a sostener la atención, plataformas de investigación en interacción humano-robot. Son escenarios donde el “valle inquietante” no es una discusión estética, sino un obstáculo práctico: si la gente reacciona con incomodidad, la interacción se corta.
Hay también un vínculo evidente con el entretenimiento y la animatrónica avanzada, pero aquí el matiz es relevante. En animatrónica tradicional, el movimiento suele estar coreografiado; el realismo se logra con guion, edición, repetición. EMO plantea un enfoque más vivo: audio a gesto en tiempo real. Eso cambia el juego para actuaciones interactivas, instalaciones, experiencias donde la respuesta no está pregrabada.
Y luego está el terreno, delicado, de la confianza. Una cara robótica más convincente puede reducir fricción y mejorar comunicación, sí; también puede intensificar la sensación de “presencia” de una máquina en contextos donde conviene medir bien el impacto. El trabajo de Columbia se presenta como investigación, no como despliegue comercial, pero su dirección es clara: crear interfaces más naturales entre humanos y robots. En esa frase caben muchas cosas, algunas buenas, otras que exigen criterio.
En paralelo, el proyecto también se entiende como una pieza más en la línea del Creative Machines Lab, que lleva años explorando aprendizaje auto-supervisado y modelos que permitan a máquinas adquirir habilidades observando, con menos dependencia de etiquetado humano y más capacidad de generalizar. EMO no aparece de la nada: es la continuación lógica de una obsesión por hacer que las máquinas aprendan comportamientos físicos complejos a partir de percepción.
Cuando la boca deja de ser un fallo y pasa a ser una herramienta
Lo que ha mostrado Columbia Engineering con EMO en enero de 2026 se puede decir sin exageración y sin quitarle fuerza: una de las grandes torpezas históricas de los humanoides —la boca desacompasada, el gesto que llega tarde, el labio que no corresponde— empieza a tener una salida técnica convincente basada en observación y aprendizaje. Hod Lipson y su equipo, con Yuhang Hu como autor clave, han combinado un rostro físicamente rico —piel de silicona, 26 motores faciales— con un entrenamiento escalonado —espejo primero, YouTube después— para conseguir una sincronía labial que se acerca bastante más a lo que el ojo humano acepta como natural.
No es perfecto y nadie serio lo vende así. Hay sonidos que cuestan, como la “B”, y gestos de fruncimiento que todavía traicionan la mecánica, como los asociados a la “W”. Pero precisamente por eso el avance se entiende mejor: no es un efecto especial, es un sistema que aprende, tropieza, corrige y puede mejorar con práctica, con más datos, con más interacción. Y en robótica social, donde un detalle mínimo puede convertir una conversación en algo incómodo, que la boca empiece a funcionar “como toca” no es un capricho estético. Es, por fin, una pieza operativa de comunicación humana puesta en una cara de silicona.


¿Dónde golpeará más fuerte la lluvia este fin de semana en España?

¿Por qué Francia congela los salarios públicos y frena las pensiones?

¿Por qué unos robots con IA saltaron a un horno de acero fundido?

¿Cuánto vivimos? La esperanza de vida mundial regresa a los 73,3 años

¿Por qué el Supremo israelí permite competir a los partidos árabes?

¿Qué cambia con la nueva pista de China en el mar de China Meridional?

¿Por qué el GP de Baréin se corre en Malasia? Leclerc manda en Sepang

¿Por qué Telecinco firma su peor septiembre histórico al caer al 8,4%?

¿Qué busca Google con Suncatcher, su primer satélite de IA en órbita?

¿Qué preguntó Trump a Grok antes de capturar a Maduro en Venezuela?

 Actualidad
¿Qué se sabe hoy de los terremotos de Venezuela y cómo sigue el país?

 Salud
¿Por qué me duelen las piernas por dentro? Causas, síntomas y alertas

 Naturaleza
¿Dónde siguen activos los incendios en España este 28 de septiembre?

 Economía
¿Cómo funciona la nueva cuenta de Revolut al 3,51% TAE en España?

 Actualidad
¿Qué pasó con el terremoto de Colombia? Balance, víctimas y réplicas

 Actualidad
San Miguel 2026: fecha, día de la semana y santoral

 Actualidad
¿Cuánto cuesta el desfile de la Fiesta Nacional en Madrid en 2026?

 Economía
¿Cuándo llega Kaufland a España y qué ciudades tendrán compra online?

 Ocio
¿Cuándo es Halloween 2026 en España y qué día se celebra este año?

 Actualidad
Calendario laboral 2026: ¿cuántos días festivos tendrás en España?

 Salud
¿Por qué mi sudor huele mal y antes no? Causas y cuándo preocuparse

 Ocio
¿Cómo queda la Liga Endesa? Fichajes, bajas y renovaciones 2026-27